Dashboard ISO 27001 - Suivi de déclaration d'applicabilité
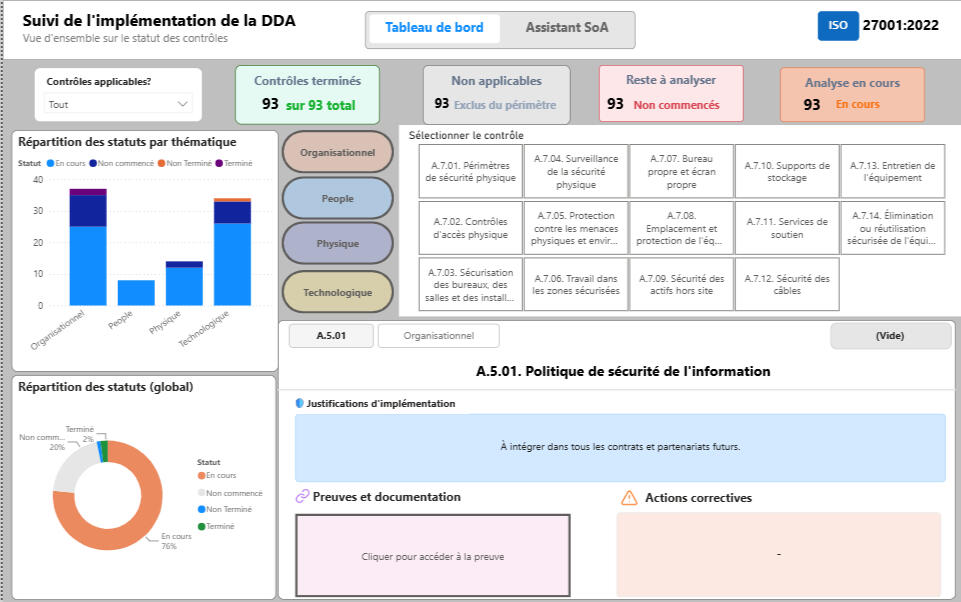
Centraliser le suivi de la conformité ISO 27001 dans un tableau de bord pour obtenir une vision claire de l'avancement des contrôles + simplifier la préparation des audits..Le contexte
L'ISO 27001 est une norme de cybersécurité qui permet d'évaluer le niveau de maturité d'une organisation et de vérifier qu'elle répond aux exigences attendues pour protéger ses informations.La problématique La préparation d'un audit ISO 27001 repose sur des dizaines de fichiers Excel, documents Word, SharePoint et échanges par e-mail, donc les informations sont dispersées : le statut d'un contrôle est dans un fichier Excel, les preuves sont stockées dans un SharePoint, les justifications sont rédigées dans un document Word, c'est vite chaotique. Il devient difficile d'obtenir une vision claire de l'état d'avancement de la conformité, les équipes passent un temps considérable à rechercher des informations plutôt qu'à faire progresser leur niveau de sécurité.La solution
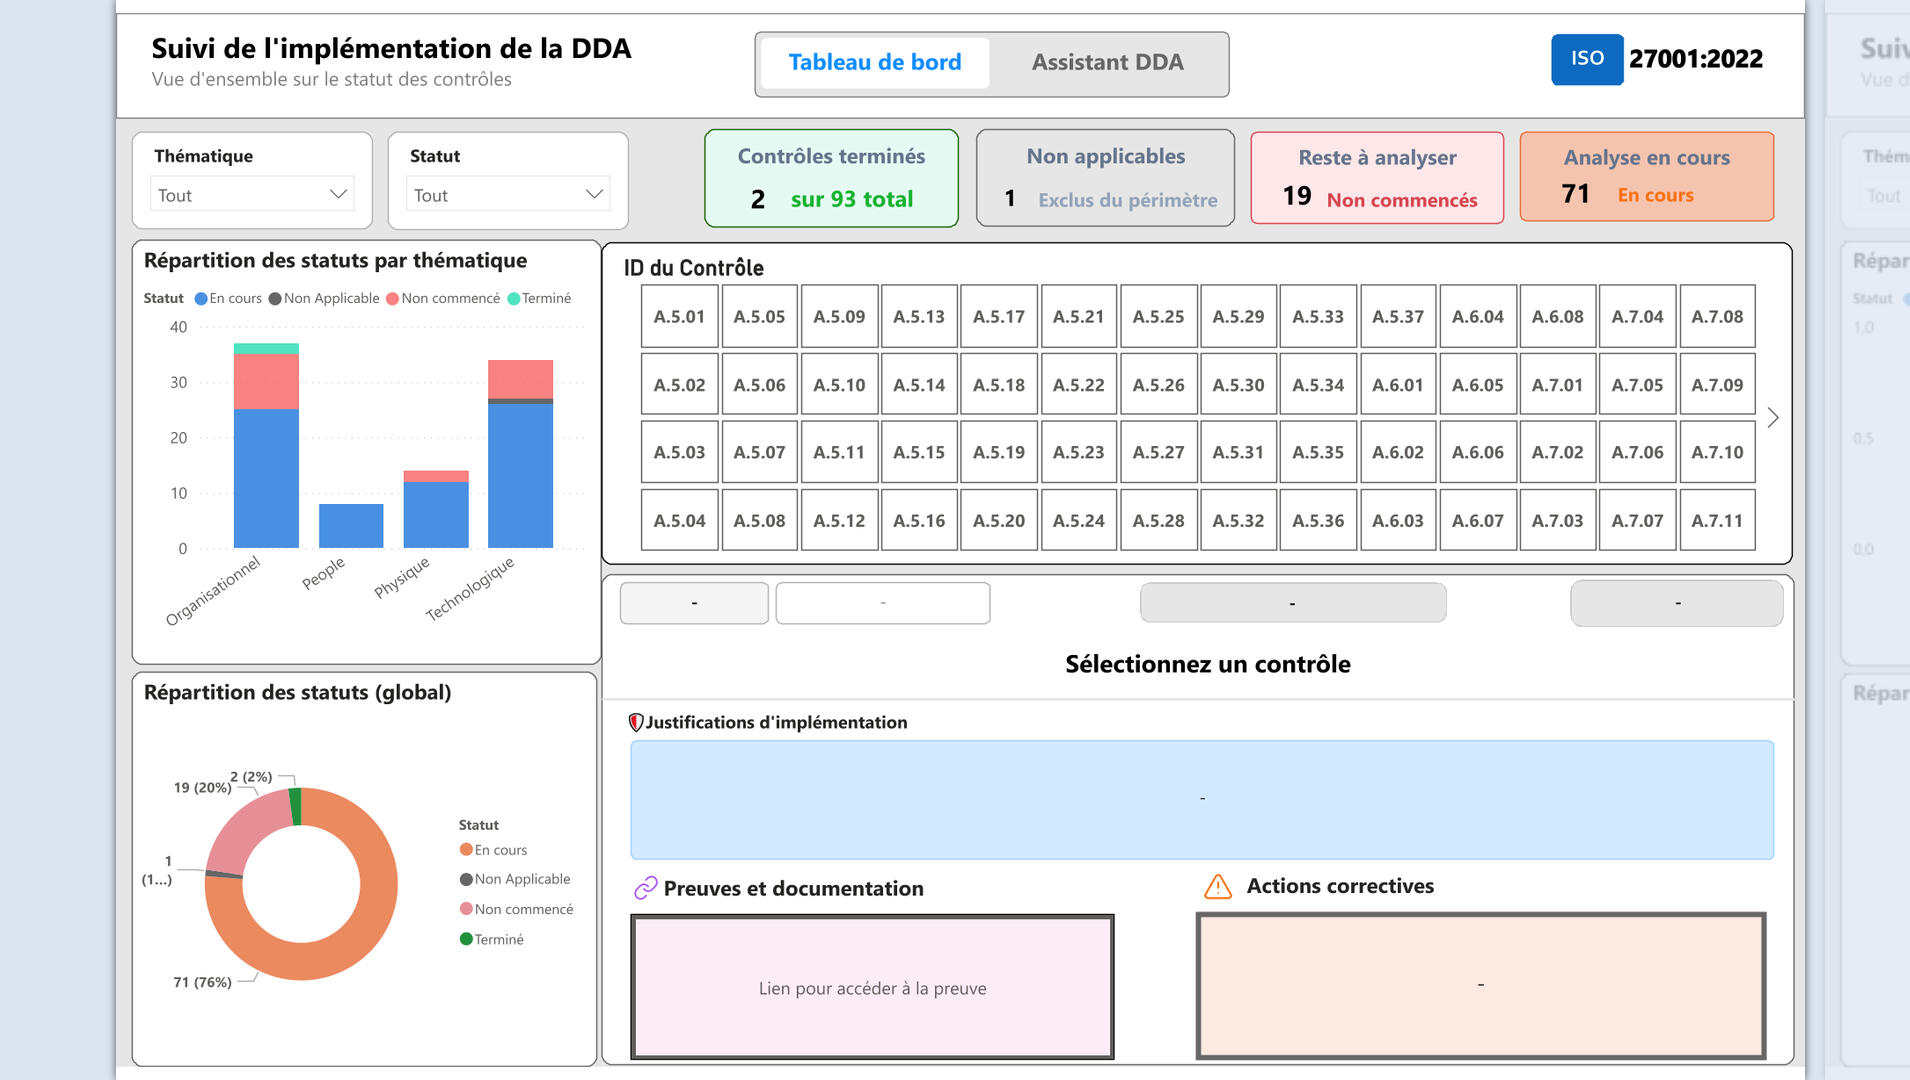
Le dashboard répond à ces questions visuellement très rapidement:
- Où en est réellement la conformité ? Quels contrôles restent à implémenter ? Quels sont les contrôles applicables ?
Qui est responsable de chaque contrôle ? Où se trouvent les preuves associées ?Une seconde difficulté
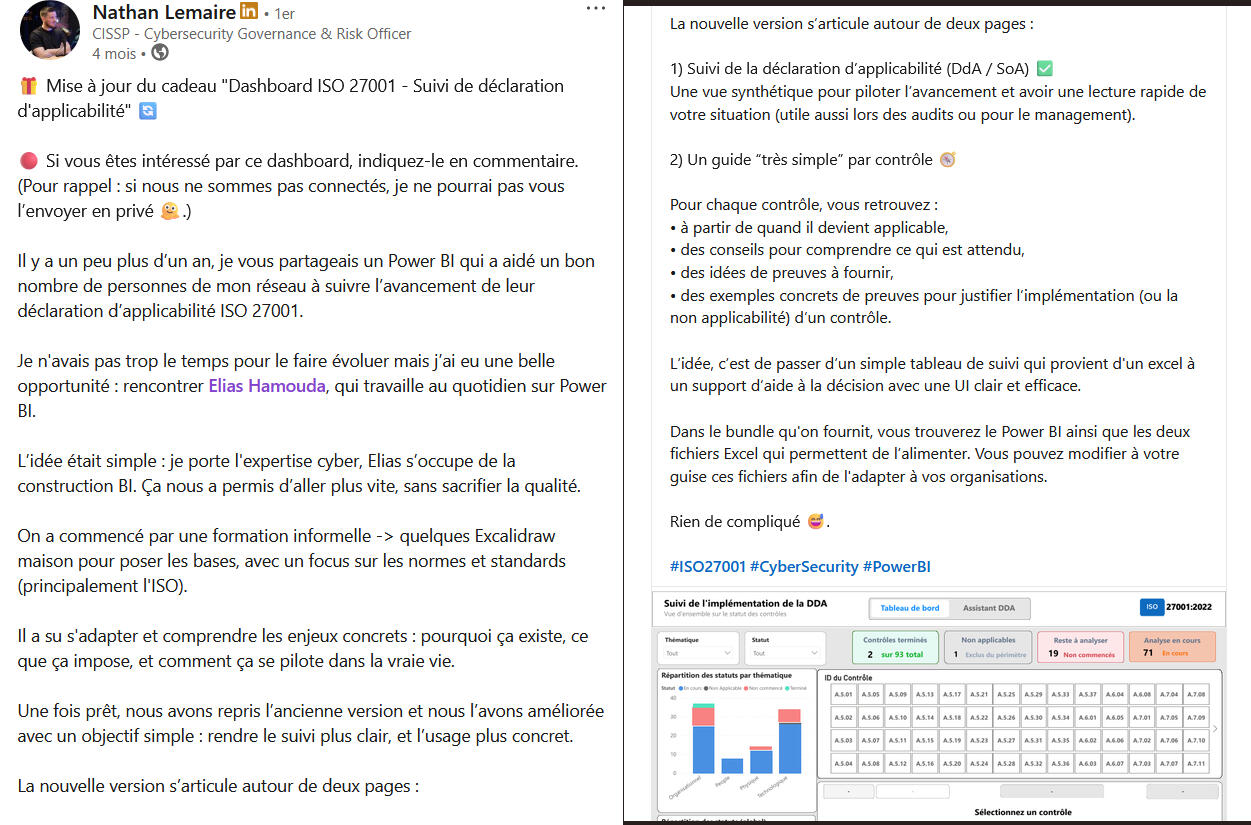
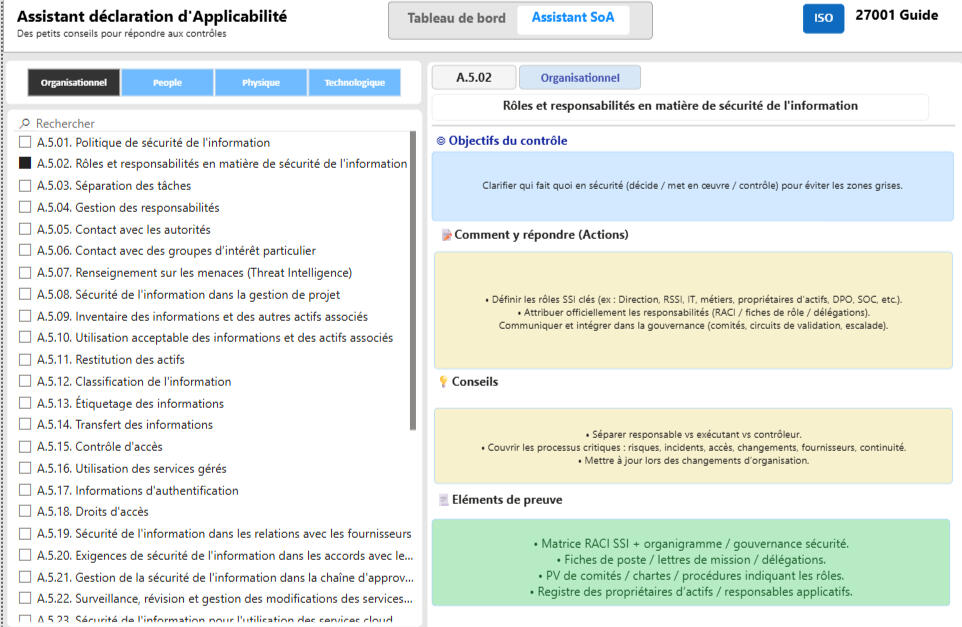
Toutes les entreprises n'ont pas une équipe cybersécurité mature.Les responsables métiers, chefs de projet et responsables qualité peuvent découvrir la norme ISO 27001 au moment où un projet de certification est lancé. Ils sont alors devant 90 contrôles, répartis dans des documents, sans vision d'ensemble.La solutionAvec Nathan LEMAIRE, Risk officer en cybersécurité, nous avons conçu un dashboard Power BI permettant de transformer le référentiel ISO 27001 en outil de pilotage.L'objectif : de centraliser l'ensemble des informations utiles dans une interface unique afin de rendre le suivi de la conformité plus simple, plus visuel et plus intuitif.
L'objectif n'était pas de remplacer la documentation ISO, mais de proposer une interface permettant d'accéder rapidement aux informations essentielles et d'offrir une vision claire de la maturité de la démarche.
Compétences mobilisées
Power BI, Power Query, DAX, Modélisation de données, Data Visualisation, UX/UI orientée tableau de bord décisionnel, Conception d'outils d'aide à la décision
Scalable ETL Pipeline: Base SIRENE & Référentiel NAF
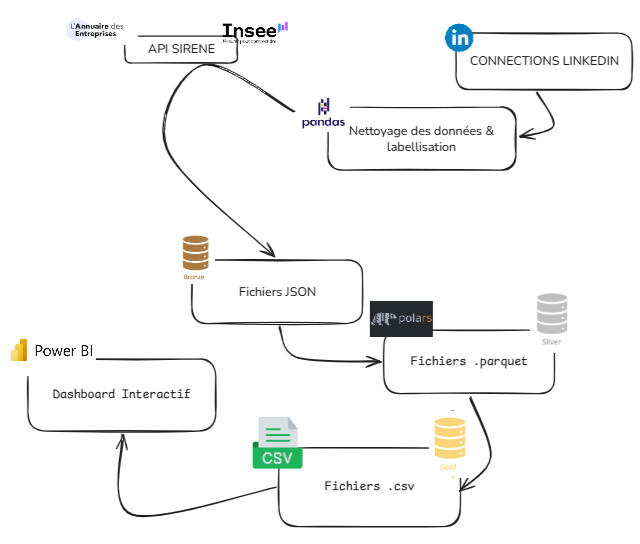
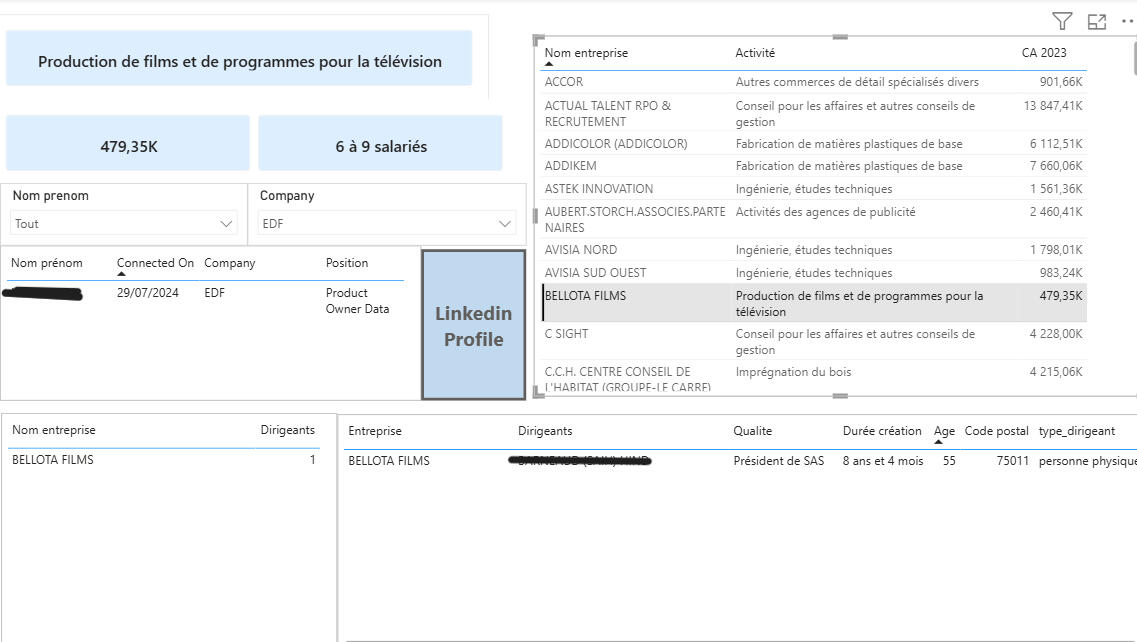
Le contexteLes données publiques sur les entreprises françaises sont riches, mais elles sont réparties entre plusieurs sources et rarement exploitables directement pour identifier rapidement des prospects ou mieux comprendre un marché.La problématiqueLorsque l'on souhaite qualifier un réseau LinkedIn, il faut généralement effectuer de nombreuses recherches manuelles : identifier les dirigeants, retrouver leurs entreprises, consulter les bases publiques, récupérer les informations administratives, les effectifs, les établissements ou encore les dirigeants.Ces informations sont dispersées et leur collecte devient rapidement chronophage dès que le nombre d'entreprises augmente.La solutionJ'ai développé un pipeline de données modulaire en Python en suivant une architecture de Data Engineering (Bronze / Silver / Gold).À partir d'une liste de connexions LinkedIn, le pipeline :identifie automatiquement les profils de dirigeants (CEO, Founder, PDG, Directeur, etc.) ;
extrait le nom de leur entreprise ;
interroge l'API officielle du gouvernement français ;
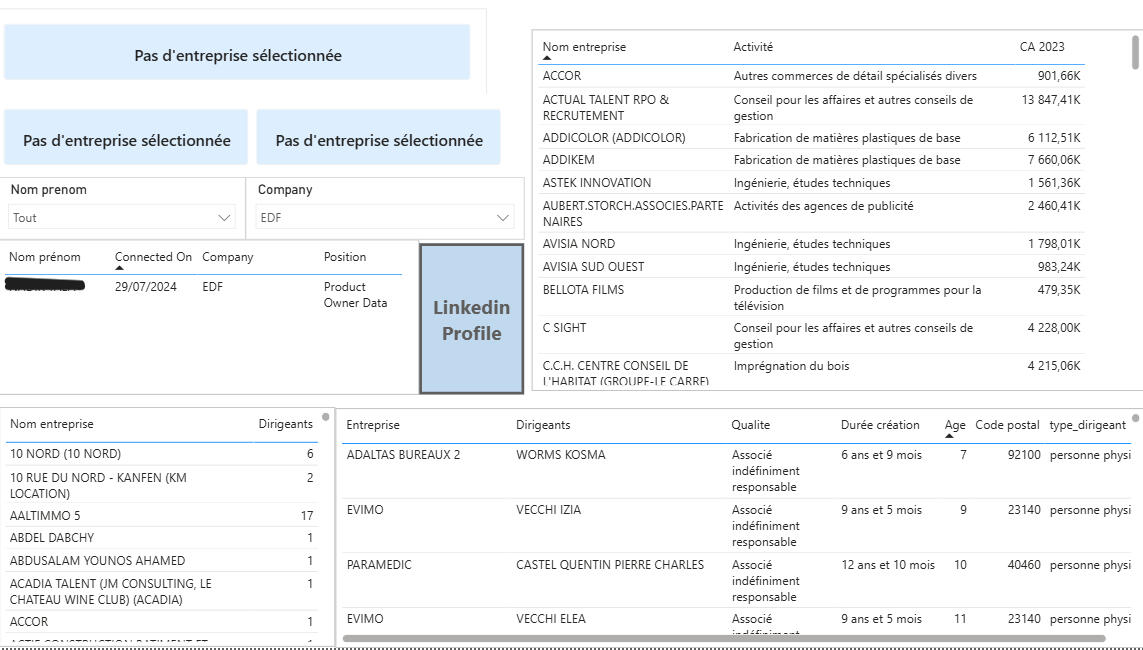
nettoie, transforme et structure les données selon une architecture médaillon.En sortie, le pipeline génère trois jeux de données :les informations administratives des entreprises (activité, siège, effectifs, chiffre d'affaires lorsqu'il est disponible...) ;
les dirigeants associés aux sièges et aux filiales ;
les établissements géolocalisés (latitude/longitude), directement exploitables dans des outils de Data Visualisation.
L'objectifL'objectif était de construire une base de données fiable permettant d'obtenir rapidement une vision d'ensemble des entreprises de mon réseau LinkedIn afin de mieux comprendre leur activité, leur taille et d'identifier plus facilement de potentiels prospects ayant des besoins en Data.Au-delà du cas d'usage, ce projet m'a permis de mettre en pratique des problématiques concrètes de Data Engineering : conception d'un pipeline modulaire, architecture médaillon, consommation d'API, transformation des données et production de datasets prêts à être analysés.Compétences mobilisées
Python, architecture Médaillon (Bronze / Silver / Gold), ETL, Consommation d'API REST, Pandas, nettoyage et transformation des données, modélisation de données, data Engineering, data Visualisation (préparation des données), conception de pipelines de données modulaires
Data Knowledge Hub — Plateforme Data Engineering de centralisation et d'analyse de contenus techniques
Le contexteLes podcasts techniques représentent une source importante de connaissances dans des domaines comme la Data, l'intelligence artificielle, le développement et l'ingénierie.Cependant, les informations sont réparties entre de nombreuses sources. Chaque podcast dispose de son propre flux RSS et les données disponibles peuvent varier en structure, en contenu ou en qualité.L'objectif était donc de construire une plateforme capable de centraliser automatiquement ces contenus et de les rendre facilement exploitables.La problématiqueComment récupérer régulièrement les données de plusieurs podcasts tout en gérant leurs différences de structure, les informations manquantes et les doublons ?Une simple collecte de fichiers RSS ne suffit pas : les données doivent être nettoyées, normalisées, stockées dans une base structurée et contrôlées avant de pouvoir être réellement exploitées.Il fallait également disposer d'une vision globale de la donnée : combien d'épisodes sont disponibles, quels podcasts publient le plus, quelles informations sont manquantes et quelle est la fraîcheur des données ?La solutionJ'ai développé un pipeline ETL modulaire en Python permettant de récupérer, transformer et charger automatiquement les données issues de plusieurs flux RSS.Le pipeline :récupère les données des podcasts sélectionnés ;
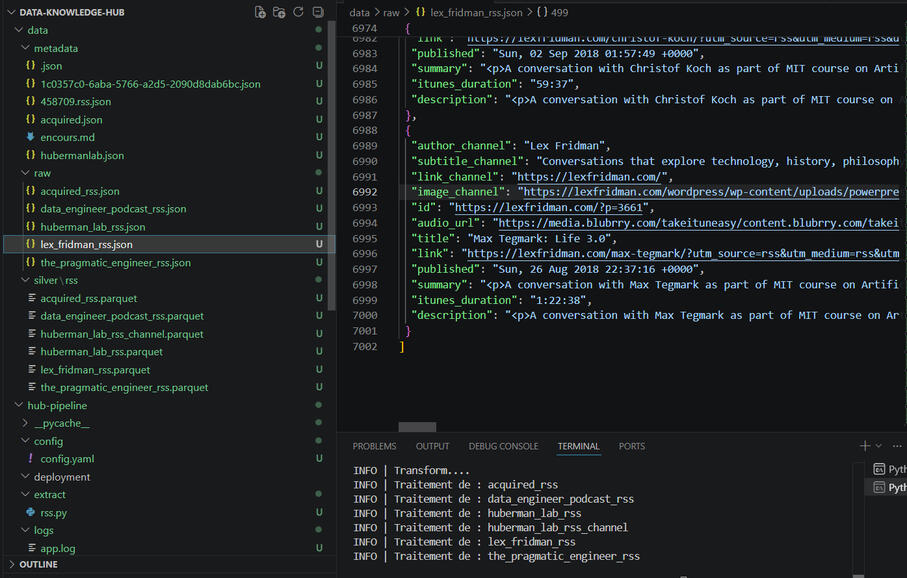
conserve les données brutes au format JSON dans une couche Bronze ;
nettoie et normalise les données avec Polars ;
stocke les données transformées au format Parquet dans une couche Silver ;
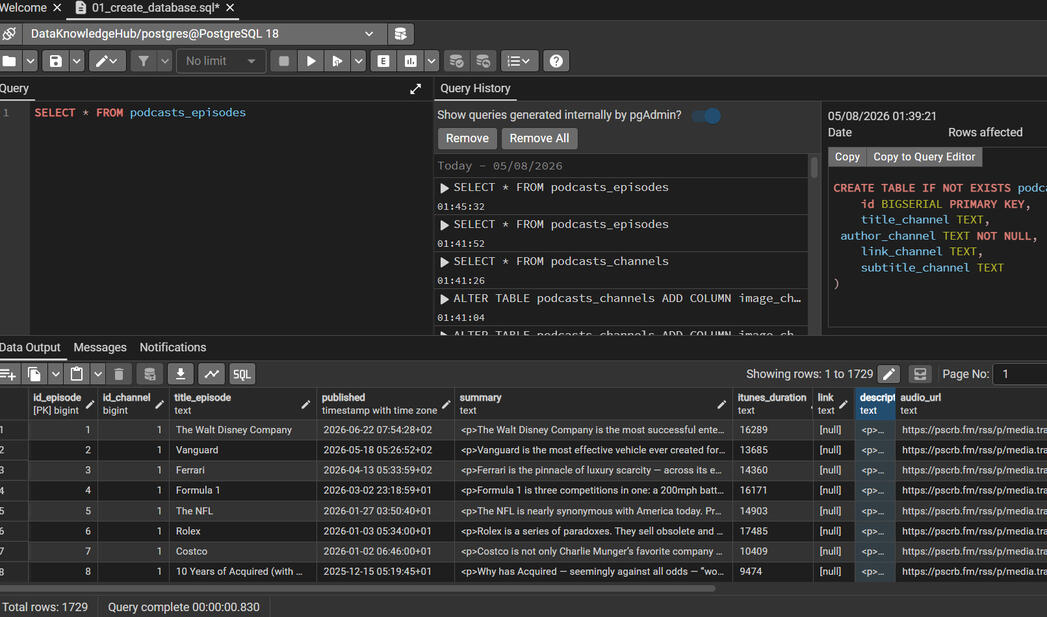
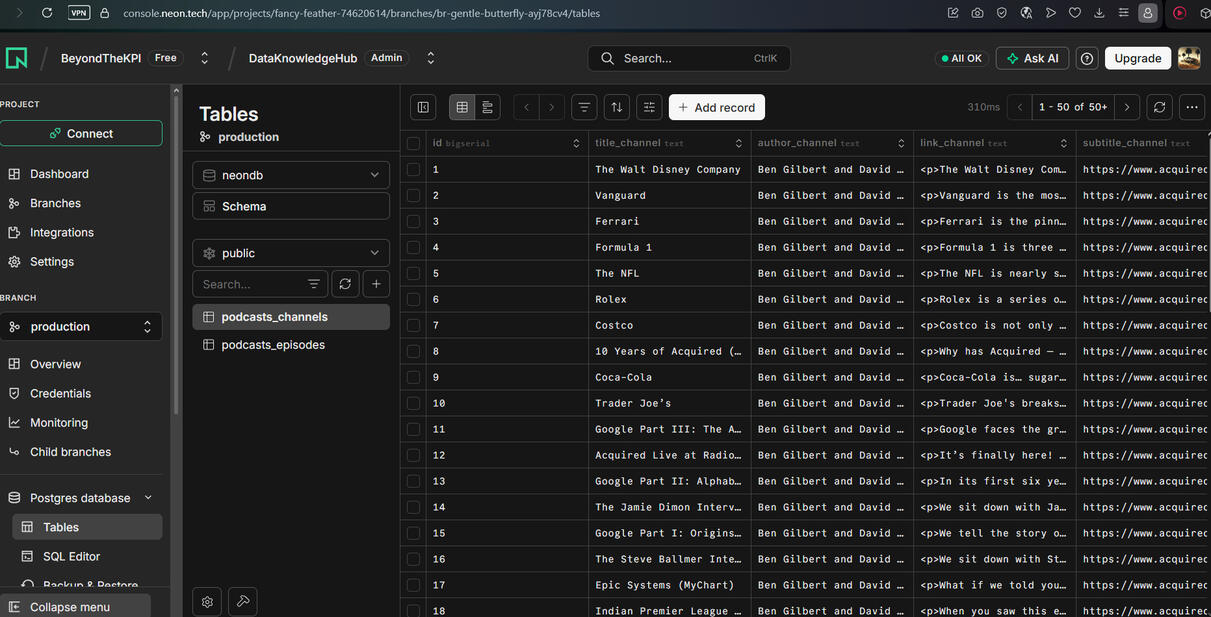
charge les données structurées dans PostgreSQL ;
utilise Neon pour héberger la base de données ;
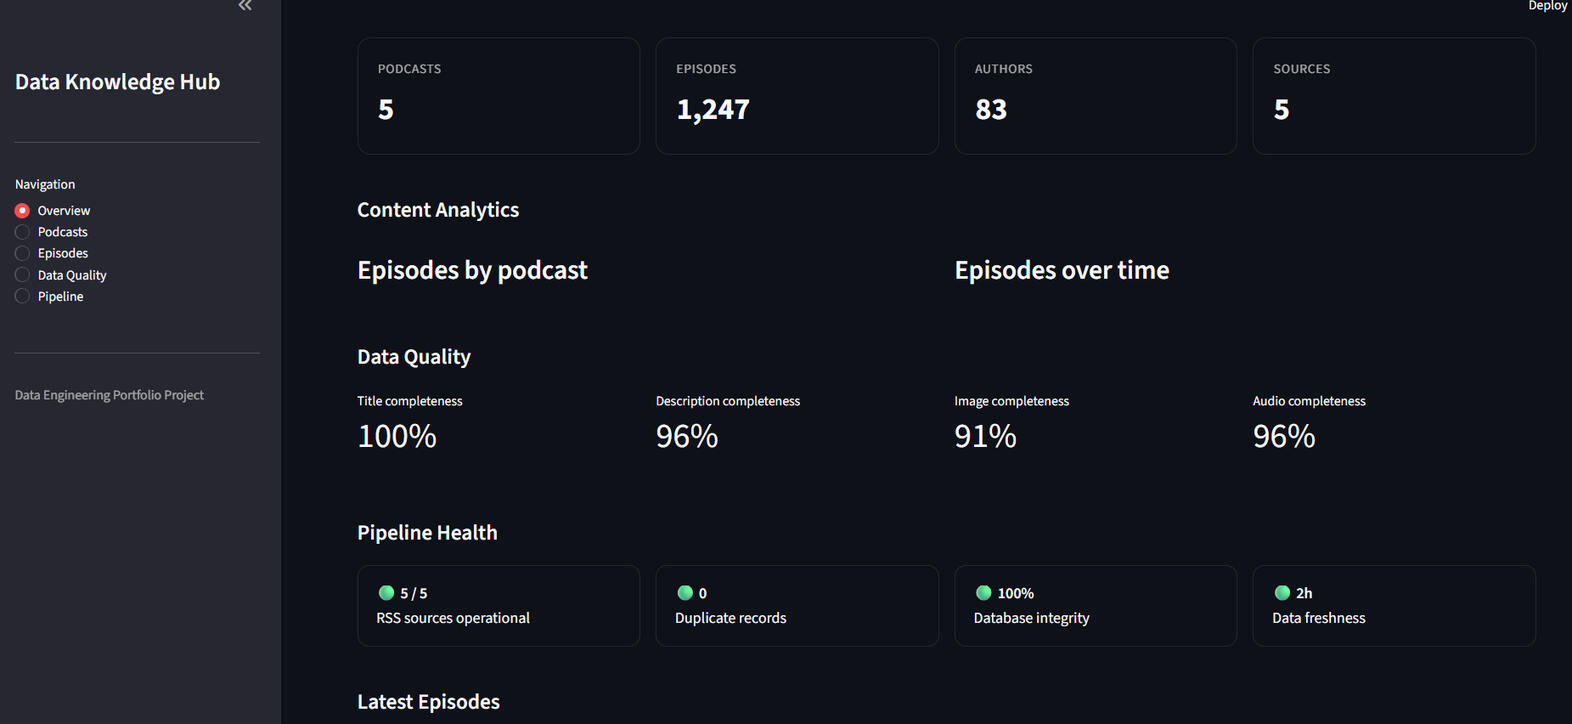
exploite SQL pour produire les indicateurs nécessaires à l'analyse.Une interface Streamlit vient compléter le pipeline afin de rendre les données accessibles à travers un dashboard interactif.Le dashboard permet notamment de suivre :le nombre de podcasts et d'épisodes ;
la répartition des épisodes par podcast ;
l'évolution des publications ;
le nombre d'auteurs ;
la complétude des différentes données ;
les doublons et problèmes d'intégrité ;
la fraîcheur des données ;
les derniers contenus disponibles.L'objectifL'objectif était de construire une véritable chaîne Data Engineering permettant de passer de plusieurs sources externes hétérogènes à une source de données centralisée, structurée et exploitable.Au-delà du cas d'usage des podcasts, ce projet permet de mettre en pratique des problématiques concrètes rencontrées dans des projets Data : ingestion multi-sources, stockage des données brutes, transformation, normalisation, modélisation relationnelle, gestion des doublons, contrôle de la qualité et exposition des données à travers une application de Data Visualisation.ArchitectureRSS → Python → JSON Bronze → Polars → Parquet Silver → PostgreSQL / Neon → SQL → StreamlitCompétences mobiliséesPython, Data Engineering, Architecture Médaillon (Bronze / Silver), ETL,RSS / XML
Polars, Pandas, Parquet, SQL, PostgreSQL, Neon, modélisation de données, nettoyage et transformation des données, streamlit, data Visualisation, conception de pipelines de données modulaires